Возьми Тессеракт. Используй его силу...Тор к Хеймдаллю
Цифровые ассистенты на "бумажной" работе - это новая нормальность
Внедрение технологий оптического распознавания символов (OCR) и роботизированной автоматизации процессов (RPA) в процессы обработки документов приводит к значительной оптимизации рабочих процессов в различных сферах деятельности, таких как HR, логистика, финансы и пр. Это связано с тем, что многие операции в этих сферах включают обработку больших объемов бумажных документов, что требует много времени и ресурсов.
Использование OCR вместе с RPA позволяет автоматизировать процесс извлечения данных из документов, уменьшая количество ошибок и повышая скорость обработки информации. Технология OCR способна работать с различными форматами документов, предварительно обрабатывать изображения, распознавать символы и слова, создавать машиночитаемые элементы, что делает её универсальным инструментом для использования в разнообразных приложениях.
RPA, в свою очередь, представляет собой набор инструментов, которые могут имитировать действия человека при работе с программным обеспечением. Роботы RPA могут выполнять рутинные задачи, такие как ввод данных, обработка транзакций, управление данными и даже отправка сообщений, что снижает трудозатраты и повышает эффективность процессов.
Комбинирование OCR и RPA позволяет достичь следующих преимуществ:
- повышение точности - автоматизация уменьшает вероятность ошибок, связанных с ручным вводом данных;
- повышение прозрачности протекания процесса распознавания и его подконтрольности для заказчика, т.к. оператор не просто передаёт документ, требующий распознавания в ней "чёрный ящик" стороннего сервиса, а получает возможность тонкой настройки использования OCR-инструмента через написание RPA-скрипта;
- увеличение скорости обработки - роботы могут работать круглосуточно без перерывов и усталости, что значительно ускоряет процессы;
- снижение затрат - уменьшение времени на обработку документов и ошибок вводит экономию на рабочую силу и коррекцию ошибок;
- улучшение доступности и управления данными - цифровизация документов облегчает их хранение, поиск по документам и анализ данных.
В современном бизнес-процессе, связанном с документальной работой, ключевую роль играют табличные данные, так как они являются основой для анализа, отчетности и принятия решений.
Табличные документы могут встречаться в различных формах, таких как:
- финансовые отчеты и бухгалтерские балансы,
- счета-фактуры, накладные и счета на оплату (в том числе их иностранные формы, например, инвойсы),
- банковские выписки,
- отчеты о продажах и покупках,
- различные виды ведомостей, например, по заработной плате или учету рабочего времени,
- инвентаризационные списки.
RPA-инструменты, такие как PIX RPA, Sherpa RPA, предоставляют возможность создания шаблонов для распознавания табличных данных из документов.
Сегодня для распознавания табличных данных в бизнес-задачах можно использовать следующие инструменты и методики:
- интеллектуальная обработка документов - это сочетание OCR для извлечения текста из сканов для выполнения монотонных манипуляций с данными и методик машинного обучения, включая компьютерное зрение и NLP (Natural Language Processing), для классификации документов и извлечения значимой информации;
- системы ERP (Enterprise Resource Planning), многие из которых имеют встроенные инструменты для обработки и анализа табличных данных, позволяя автоматизировать процессы, связанные с учетом, планированием ресурсов и отчетностью;
- CRM (Customer Relationship Management) - часто содержат модули для обработки табличных данных, связанных с клиентскими отношениями, продажами и маркетинговыми активностями;
- специализированное RPA-программное обеспечение, такое как UiPath, Blue Prism, и Automation Anywhere, предлагают расширенные возможности для работы с табличными данными, включая интеграцию с Excel и другими офисными пакетами, для обработки и манипуляции данными;
- интеграцию с веб-сервисами - роботы RPA могут взаимодействовать с API веб-сервисов для загрузки, извлечения или обновления табличных данных в режиме реального времени.
В рамках данной статьи мы уделим внимание изучению особенностей применения программы для распознавания текстов "Tesseract", отличительными преимуществами которой являются:
- бесплатность - делает данный инструмент идеальным для проектов с низким бюджетом, старта применения RPA в связке с OCR и в целом для малого и среднего бизнеса;
- универсальность - при должном навыке разработки инструмент может применяться для широкого круга задач, от простого распознавания текста, до работы с непредсказуемым количеством строк в табличной части документов;
- интегрированность - в таких отечественных продуктах, как PIX RPA, модуль "Tesseract" входит в стандартную поставку и оптимизирован под активности для написания скрипта.
Использование Tesseract в RPA-задачах
Применение Tesseract для распознавания табличных данных в рамках процессов RPA может значительно улучшить эффективность автоматизации различных бизнес-операций. Рассмотрим основные этапы использования Tesseract для извлечения табличной информации и интеграции полученных данных в RPA-системы.
Шаг 1: Предварительная обработка изображений
Перед началом работы с Tesseract необходимо провести предварительную обработку изображений (препроцессинг), чтобы улучшить качество распознавания текста. Ключевые этапы препроцессинга включают в себя:
- преобразование в оттенки серого для уменьшения сложности данных,
- удаление шума для повышения чёткости текста,
- бинаризация для разделения текста и фона,
- коррекция перекоса, обеспечивающая горизонтальное выравнивание текста,
- использование библиотеки OpenCV для предварительной обработки изображения и получения координат ячеек таблицы,
- нахождение контуров и фильтрация ненужных элементов, таких как штрих-коды, с помощью pyzbar и последующей обработки контуров,
- кластеризация ячеек по высоте и ширине для исключения элементов, которые не являются частью таблицы,
- построение графа, где каждая ячейка таблицы представляется как вершина, а связность определяется на основе близости прямоугольников. Это позволяет определить соседние ячейки и их взаимное расположение.
Шаг 2: Распознавание текста с помощью Tesseract
После препроцессинга следует применение Tesseract для извлечения текстовых данных. Tesseract хорошо справляется с изображениями высокого качества, но может испытывать трудности с распознаванием сложных шрифтов или низкокачественных изображений. Использование Tesseract в Python:
Распознавание текста в каждой ячейке с помощью Tesseract, возможно, с несколькими попытками распознавания для повышения точности.
Шаг 3: Обработка и анализ извлеченных данных
После извлечения текста необходимо обработать и структурировать данные. Этот шаг включает в себя разбиение текста на строки и столбцы, их очистку и преобразование в нужный формат для дальнейшего использования в RPA-системах.
Требуется подготовка алгоритма сборки данных из ячеек в структурированный формат, например, JSON, для дальнейшей обработки.
Именно этому шагу мы уделим более пристальное внимание в рамках данной статьи.
Шаг 4: Интеграция с RPA
Интеграция распознанных и обработанных данных в RPA-систему позволяет автоматизировать процессы, требующие работы с табличными данными. Встраивание результатов распознавания в RPA-скрипт помогает использовать эти данные для выполнения различных задач, таких как ввод данных в системы, их анализ или генерацию отчетов.
Каждый из перечисленных выше шагов требует тщательной настройки и может быть ресурсоемким, в результате чего скорость обработки одной страницы PDF может составлять от 20 секунд до минуты. Это подчеркивает, что Tesseract в базовом функционале не умеет размечать считанную таблицу в объект DataTable и требует дополнительных алгоритмов для её обработки.
Проблемы, ограничения и выбор метода
На практике, на разработчика-роботизатора обрушивается целый шквал трудностей, которые невозможно обойти без понимания необходимых тонкостей "настройки" такого инструмента, как Tesseract, для получения преимуществ OCR в RPA-задачах.
При работе с Tesseract важно учитывать его ограничения. Tesseract по-умолчанию не способен правильно определять порядок чтения документов и структуру таблиц.
Tesseract распознает текст в таблицах с множеством колонок и строк путем анализа отдельных блоков текста. Он не определяет таблицы как структурированные данные, а вместо этого работает с ними как с обычным текстом, который случайно организован в строки и колонки. При обработке многостолбчатых таблиц Tesseract может столкнуться с проблемами, так как он:
- рассматривает каждый текстовый блок независимо, без учета табличной структуры;
- иногда неправильно интерпретирует пространство между колонками, что приводит к ошибочному слиянию текста из разных ячеек;
- может не соблюдать порядок ячеек и строк, если они не отформатированы явно и последовательно.
Перечислим ряд ограничений, которые могут повлиять на качество распознавания таблиц.
- Качество изображения - низкое разрешение изображения или плохое качество печати могут затруднить распознавание текста, в результате чего Tesseract может пропустить или неправильно интерпретировать символы. Например, запятые могут быть восприняты, как точки, а ноли в числах, как буквы "о".
- Сложность макета - Tesseract лучше всего справляется с простыми макетами. Сложные макеты с множеством колонок, различным шрифтом и размерами текста могут привести к ошибкам в определении структуры таблицы.
- Стили таблиц - таблицы без границ или с перекрывающимися линиями могут вызвать проблемы с правильным определением границ ячеек.
- Многострочный текст в ячейках - если текст в ячейках таблицы распределен по нескольким строкам, Tesseract без дополнительно-прописанных алгоритмов работы не распознает структуру ячеек и объединит текст неправильно.
- Шрифты и стили - нестандартные шрифты и сложные стили текста также могут снижать точность распознавания текста Tesseract.
- Декоративные элементы - графические элементы, такие как логотипы или украшения внутри таблиц, могут быть ошибочно распознаны как текст.
- Поворот текста - если текст в таблице повернут или наклонен, это может затруднить его распознавание. Наклон отсканированного документа более чем на 5 градусов приводит к проблемам с распознаванием.
- Цветовое оформление - таблицы с разноцветным фоном или текстом требуют предварительной обработки для улучшения контрастности и удаления фоновых элементов.
Решение этих проблем требует дополнительной обработки данных или использования более сложных алгоритмов машинного обучения.
Для улучшения результатов обработки табличных данных можно использовать несколько подходов.
- Ручная зональная разметка - разработчик может вручную указать области (зоны) для распознавания, что помогает OCR-движку сфокусироваться на конкретных участках изображения и правильно интерпретировать структуру таблицы. Это может быть эффективно при обработке небольшого количества документов.
- Обнаружение границ таблицы - если в таблице имеются чётко выраженные границы, можно попробовать алгоритмы для обнаружения горизонтальных и вертикальных линий, чтобы разделить изображение на ячейки. Затем можно выполнить OCR для каждой ячейки и собрать результаты в двумерный массив.
- Удаление границ ячеек - в случае таблиц без границ можно попробовать удалить все длинные горизонтальные и вертикальные линии перед OCR, что позволит улучшить распознавание текста внутри ячеек.
- Использование коммерческих OCR-решений, таких как ABBYY FineReader, OmniPage Ultimate от Kofax или Adobe Acrobat Pro DC, которые обычно обладают более высокой точностью распознавания и лучше справляются с автоматическим определением структуры таблиц, но они стоят денег.
- Дополнительные алгоритмы для анализа данных - можно использовать алгоритмы машинного обучения или паттерн-мэтчинг для интерпретации и структурирования распознанных данных, что может потребовать более глубокого изучения предметной области и создания правил для кросс-проверки данных.
- Постобработка OCR-результатов - после распознавания текста может потребоваться дополнительная обработка данных для восстановления структуры таблицы, такая как анализ распределения пробелов и выравнивания текста, а также применение специальных символов для обозначения границ ячеек.
Выбор подходящего метода зависит от конкретных требований задачи, качества исходных изображений и доступных ресурсов. Важно провести тестирование различных подходов, чтобы определить наиболее эффективный способ обработки табличных данных для конкретного случая.
В рамках настоящей статьи, мы рассмотрим плюсы и минусы и приведём пример комбинации методов из вышеуказанных пунктов №№ 5. и 6. - патерн-мэтчинга, в сочетании с постобработкой OCR-результатов.
Патерн-мэтчинг, в сочетании с постобработкой OCR-результатов
Помимо обозначенных в начале статьи общих преимуществ использования программы "Tesseract", по сравнению с более "мощными", но специализированными и/или дорогостоящими альтернативами, выбор сочетания методов патерн-мэтчинга и постобработки OCR-результатов, содержит в себе ряд специфических преимуществ и недостатков, которые важно учитывать при применении данного подхода в RPA-задачи.
Прежде, чем изложить данные преимущества и недостатки, разберём один из практических примеров.
Описание задачи
Ежедневно сотруднику компании приходят на почту архивы с морскими транспортными накладными. В каждом документе десятки страниц, среди которых можно выделить две основные сущности «Tax Invoices» (Налоговые счета) и «Packing List» (Товарные накладные). Задача цифрового сотрудника по каждому документу заключается в том, чтобы установить соответствия между сущностями и перенести определенные значения по каждой паре в учетную систему, выполнив тем самым операцию «Прием и проведение импорта».
Скриншоты документов
Как было сказано выше, в каждом архиве десятки страниц. Не каждая страница документа имеет смысловую нагрузку для данного процесса. Нас интересуют две конкретные сущности: Tax Invoice и Packing List, они будут приведены далее.
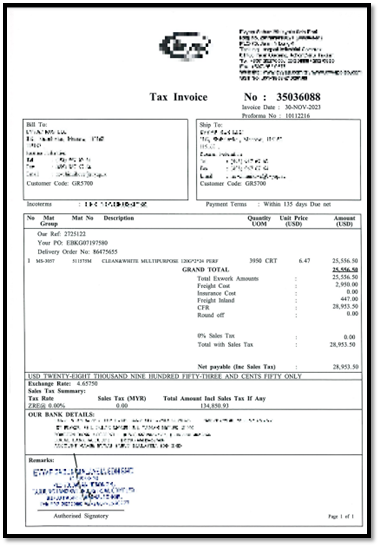
Рис.1. Tax Invoice
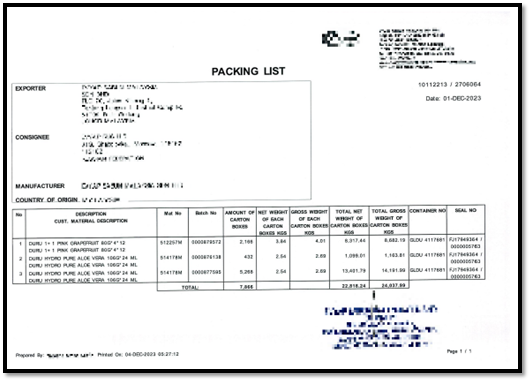
Рис.2. Packing List
Описание сложностей
- Архивы содержат .pdf файлы, которые не содержат текстового слоя. Так появляется задача распознавания текста с изображений.
- Интересующие нас данные находятся, в том числе, в табличной части документа.
- Некоторые сканы могут быть развернуты на ±90°, относительно книжной ориентации.
- В связи с ограничениями бюджета на решение задачи требовалось осмотрительно подходить к выбору инструмента для реализации.
- Сущности «Tax invoice» и «Packing list» требуется разбить на пары, при этом сами страницы могут быть «разбросаны» в архиве в случайном порядке.
Но, обо всем по порядку.
Описание решения
Дисклеймер:
Данное решение сработало для нас, но при других вводных может не сработать в нужной степени для вас.
При обсуждении задачи с командой было сказано философское – нужно чтобы «удачно сошлись звезды», а после эта фраза стала локальным мемом и, да, звезды сошлись.
С самого начала было ясно, что потребуется OCR-инструмент для извлечения нужных данных. Варианта, по большому счету, всего два: либо искать нечто готовое под данный тип документа среди платных сервисов, либо делать это распознавание с нуля.
Проведя небольшое исследование стало понятно, что на рынке нет готового сервиса под работу с данным документом. Большинство сервисов по распознаванию используют «под капотом» машинное обучение, и нам дали понять стоимость такого обучения на нашей выборке документов. Подобное решение из разряда «премиум-сегмента» было бы прекрасным решением, ведь оно способно классифицировать разные документы, выполнять пред- и пост-обработку и, что важно, работать с табличными частями проверяя итоги своей работы. Но, в связи с ограничениями бюджета накладные расходы по обучению системы и ее интеграции в закрытый контур оказались не по карману.
Далее, взгляд упал на RPA-платформу PIX Studio, как некий ящик с инструментами, в котором «все есть»:
- можно работать с электронной почтой по протоколам imap/smtp, а значит мы получим нужные письма с документами;
- имеются встроенные модули для работы с OCR (интеграция с онлайн сервисами и бесплатный Tesseract), значит потенциально сможем закрыть вопрос с распознаванием;
- есть возможность интерфейсных манипуляций с SAP, значит сможем использовать робота как «шину данных» по переносу информации в учетную систему.
В демо‑режиме PIX Studio, без приобретения лицензии можно протестировать применимость данного инструмента к решаемой задаче.
Так выглядел минимальный «набор джентельмена» для подступа к данной задаче на старте. В коробочной версии RPA‑платформу поставляется бесплатный Tesseract который, несомненно, имеет свои недостатки, но нужно было с чего‑то начинать эксперименты, и упомянутая библиотека стала первым кандидатом на использование.
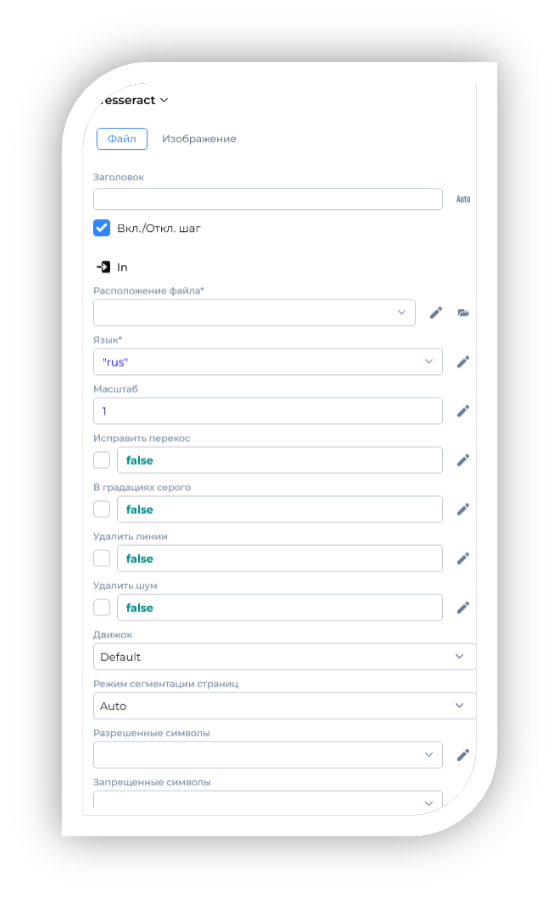
Рис.3. Начало настройки Tesseract
- В демо‑режиме PIX Studio, без приобретения лицензии можно протестировать применимость данного инструмента к решаемой задаче.
Так выглядел минимальный «набор джентельмена» для подступа к данной задаче на старте. В коробочной версии RPA‑платформу поставляется бесплатный Tesseract который, несомненно, имеет свои недостатки, но нужно было с чего‑то начинать эксперименты, и упомянутая библиотека стала первым кандидатом на использование.
Для того чтобы воспользоваться возможностями библиотеки распознавания потребуется в качестве входного параметра передать изображение. И здесь первая «засада», правда небольшая. Исходный файл является pdf-файлом, а нужные страницы – pdf-листами.
Чуть выше говорили о том, что в возможностях RPA-платформы есть многое. Применив отдельную активность по конвертации pdf-файла в изображения, мы смогли извлечь все листы документа в нужном формате.
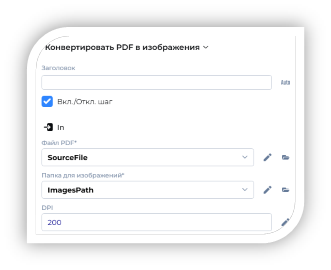
Рис.4. Настройка pdf-конвертации
Здесь лишь стоит упомянуть то, что при конвертации пришлось поэкспериментировать с параметром DPI для приемлемого результата дальнейшего распознавания, ведь именно эти файлы дальше будут нашими исходниками.
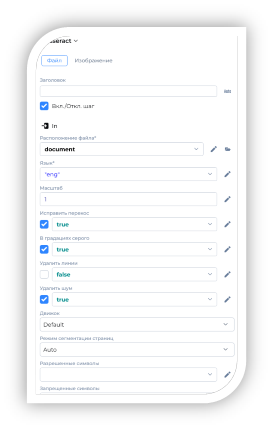
Рис.5. Настройка Tesseract
Пробуем распознать какой-нибудь документ и здесь начинается «подбор наиболее удачных» параметров для получения удовлетворительного качества.
Здесь хочется отметить пару моментов:
- Да, мы осознаем что фиксация жестких параметров работает конкретно "для этого типа документов, этого качества" и т.д.
Данное ограничение нивелируется тем, что само распознавание – условно "бесплатно", а его итоги – вполне устраивают.
- Наиболее наблюдательные из вас обратят внимание, что есть языковой параметр, установленный в “eng”.
В мультиязычных исходниках появится проблема подмены одних символов – другими. Например, «к и k» и прочие визуально схожие символы [o, u, e, p, x, c…]. В связи с этим, не получится удобно использовать регулярные выражения, ведь мы заранее не знаем какой из символов, где и как будет подменен.
Но, в нашей задаче «сошлись звезды» и исходники содержат текст на одном языке.
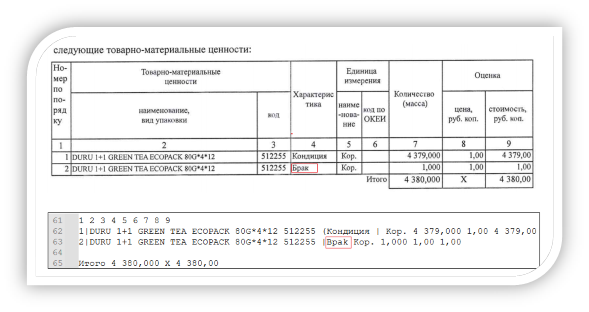
Рис.6. Работа с мультиязычными документами
Пример того, как выглядит подмена символов в мультиязычных документах представлена выше. Это неуправляемый фактор, который может сказаться на качестве распознавания
Поэкспериментировав с DPI при преобразовании, с параметрами при распознавании получили следующий результат (см. ниже). В каждом исходнике нас интересует шапка документа и обязательно (!) некоторые значения табличной части. Поэтому сразу устремив взгляд в итоги по таблице мы увидели весьма сносный результат. Да, это не какой-нибудь удобно размеченный json, в котором будет отдельное свойство под таблицу и перечисление строк. Но, ожидая увидеть «кашу из символов» получили хороший результат на каждом из файлов. Минимальный тест Tesseract прошел и «звезды сошлись» в очередной раз. На некоторых примерах будет приведена табличная часть Tax Invoice-а, где-то Packing list-а.
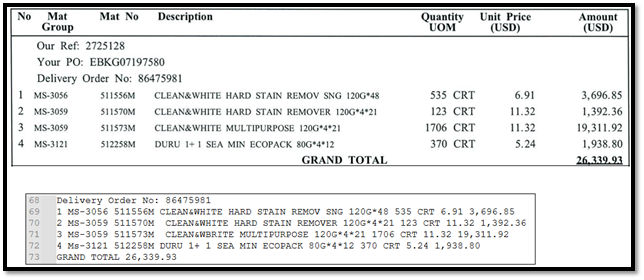
Рис.7. Результат экспериментов с DPI при преобразовании и с параметрами при распознавании
Что для этого было нужно?
- Хорошее качество сканирования: после конвертации листов в изображения с DPI 200 мы получили файлы размером 1.5-1.8МБ с разрешением 1652х2338.
- Последовательность строк после распознавания не нарушала свой порядок, относительно исходника.
- Весь текст в рамках одного алфавита.
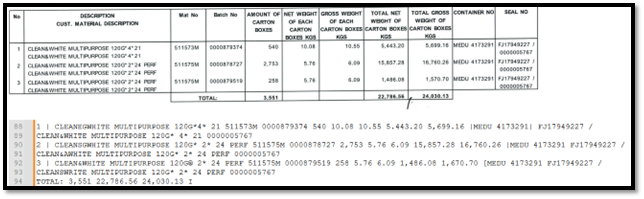
Рис.8. Пример файла «как есть» и итог распознавания.
Стало интересно, каков запас прочности у подобного распознавания и где та граница перекоса, после которого всё начнёт рушиться?
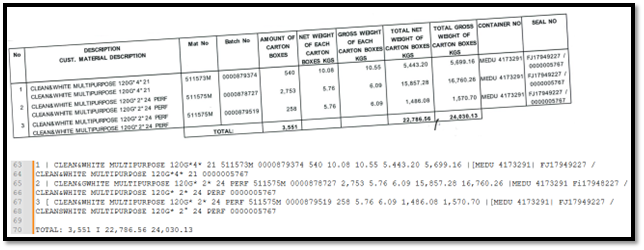
Рис.9. Пример результата, если внести относительно небольшой перекос (<5°) и запустить распознавание с флагом учета
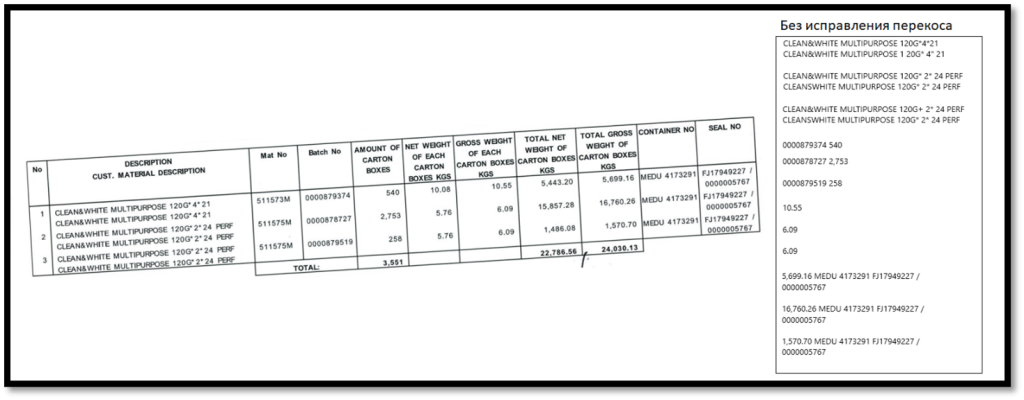
Рис.10. Если имеющийся перекос не учитывать при распознавании
Сразу же строка «разрывается» на несколько отдельных блоков, разбросанных по тексту. Более того, в данном примере вовсе был потерян столбец с артикулами, что является неприемлемым результатом.
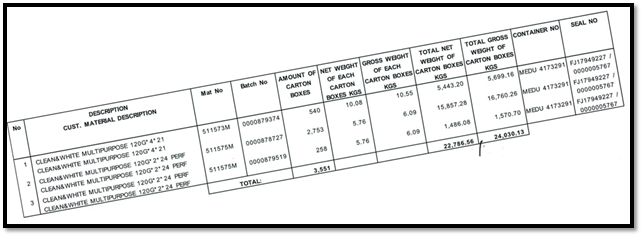
Рис.11. Вносим более экстремальный перекос (>10°)
Был преодолен тот рубеж, после которого Tesseract вернет пустой текст с изображения.
Ну уж теперь мы можем взять лист любого документа из нашего пула и финально распознать его?
Да, но нет.
Здесь вторая небольшая загвоздка, ведь при сканировании пачки листов ориентация документа в общем архиве может быть любой. Эксперименты показали, что Tesseract справляется только с книжной ориентацией, значит нам нужно ее «восстановить», перед тем как пытаться извлечь параметры документа.
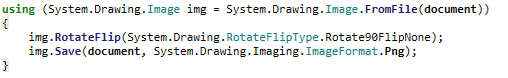
Тут пришлось условиться, а наличие какого текста говорит нам о том, что файл ориентирован «нормально». После определения набора таких условий мы без особых усилий вращаем исходник на 90 градусов, учитываем перекосы, распознаем и повторяем в случае необходимости.
Итак, Tesseract базово справляется с тем качеством исходников, которые мы ему отправляем на вход. Перекосы в разумных пределах так же не явились глобальной проблемой. Порядок строк таблицы не нарушается.
Теперь имеет смысл попробовать достать необходимые значения из ячеек таблицы, ведь у нас не было никаких беспокойств по определению значений вне таблицы. В худшем случае, можно «заякориться» на одном из элементов нужного документа, и далее динамически пересчитывать нужные отступы до прямоугольников искомых параметров.
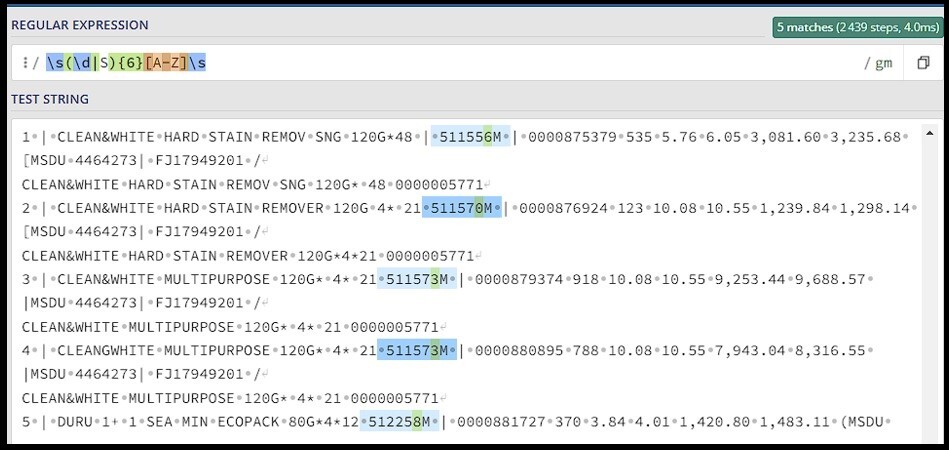
Рис.12. Работа с регулярными выражениями.
Настал черед, вооружившись регулярными выражениями, пройтись по тексту таблиц. Для проведения импорта в SAP нам обязательно потребуется получить список номенклатур, взят он будет с листа Packing List. Решая задачу «в лоб» была распознана тестовая пачка документов, проанализировав итоги и отклонения удалось сформулировать лаконичное регулярное выражение под артикулы.
Аналогичным образом были написаны регулярные выражения под вес товара из товарной накладной, для суммы по каждому артикулу из налогового счета. Было не все так идеально, ведь местами встречались погрешности распознавания (не тот символ), но в интересующей нас части таких отклонений присутствовало минимальное количество, а с теми, что возникли, удалось либо справиться вовсе, либо отклонять файл от обработки.
То, что последовательность строк после распознавания не менялась, позволило разбить интересующие параметры на массивы одинаковой размерности и по индексам «воссоздать» кусочки табличной части. Но, мы все еще не застрахованы от подмены символов, особенно критично это сказывается на весе товара и сумме. В связи с этим, мы решили использовать TOTAL значения и по сумме, и по весу, которые присутствуют под таблицей. Таким образом, появилась возможность малой кровью проверить полученные значения и, при необходимости, отклонить документ на обработку оператором.
Испытав чувство облегчения, можно было приступить к оставшейся алгоритмической части, ведь инструмент, удовлетворяющий потребности по OCR, был найден. Оставшаяся часть была лишь делом техники, нужно лишь вернуться к началу задачи. Распознавать каждый лист и определять его в одну из сущностей «Налоговый счет», либо «Товарная накладная». По каждой из сущности извлекать номера документов и устанавливать отношения между листами «Товарная накладная относится к налоговому счету». Нюансом здесь было лишь то, что «Товарная накладная» может располагаться на нескольких листах, поэтому требовалось найти все листы для текущего «Налогового счета». Разбив все листы исходного архива по парам, нужно извлечь базовый минимум из каждой пары, проверить значения, выполнить некоторые оптимизации и пересчеты, подготовить информацию для внесения в SAP. Итоговым результатом данного этапа являются json-файлы по каждой найденной паре, а уже с этой информацией работает RPA-робот в части внесения импорта в учетной системе SAP.
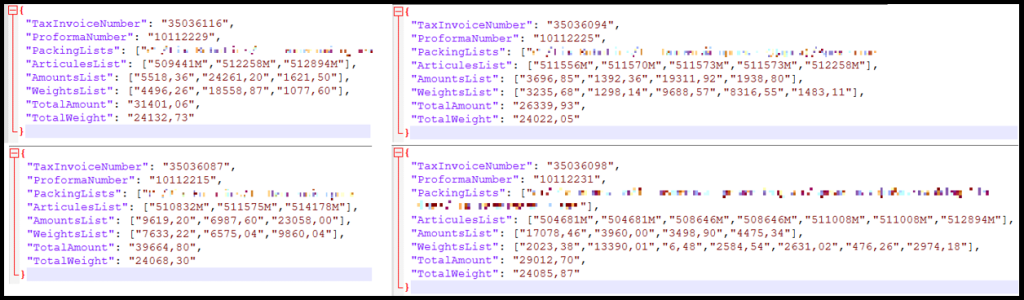
Рис.13. json-файлы
Преимущества подхода
- Бесплатное извлечение текста. Не пришлось использовать дорогостоящие сервисы по распознаванию, RPA-платформа в базовом функционале справилась с данным процессом, а в моменты простоя может принести пользу в других процессах.
- Решение работает в закрытом контуре сразу из коробки, не обмениваясь документами с облачными решениями.
- Возможность встраивания механизмов проверки.
Недостатки подхода
- Жёсткая привязка к структуре и содержанию рассматриваемых сущностей «Tax Invoices» и «Packing list». Некоторые изменения документов могут быть критичными.
- Распознавание Tesseract в RPA-платформе является своего рода "ящиком с инструментами", на который нет возможности влиять кроме как доступными параметрами. Если перебор параметров (инструментов) исчерпал себя и не дал результатов, тогда появляется задача поиска альтернативных OCR-инструментов.
Выводы
Резюмируя данный эксперимент хочется зафиксировать основные моменты, которые позволили не стрелять из пушки по воробьям.
- разумеется, определяющее значение играло качество исходных файлов. В противном случае, придется искать более современный инструмент, который, вероятно, будет стоить бóльших финансовых вложений. Здесь под качеством, в том числе, имеется ввиду отсутствие сильных (>10°) перекосов;
- требовался инструмент, который умеет в OCR, в работу с электронной почтой и SAP. Решено было протестировать RPA-платформу как единый инструмент для всего бизнес-процесса;
- отсутствие нескольких языков в рамках одного листа, ведь это одно из ограничений бесплатного Tesseract, которое качественно влияет на результат;
- удалось из «коробки» подобрать комбинацию параметров для конвертации в изображения и последующего распознавания для отличного результата в текстовом виде;
- после тестирования «разношерстных» пакетов документов было выявлено ограниченное количество «типовых» отклонений при распознавании, которые удалось нивелировать пост-обработкой;
- отсутствие ошибок/опечаток в самих документах, что позволяет хотя бы минимально перепроверять итоги распознавания.
Заключение
Использование Tesseract в рамках RPA для распознавания табличной информации может существенно повысить скорость и точность обработки документов. Однако, для достижения наилучших результатов важно правильно подготовить изображения документов, учесть ограничения OCR-системы и обеспечить качественную интеграцию распознанных данных в RPA-процессы.
Если по итогам прочтения данной статьи Вы заинтересовались в роботизации Ваших бизнес-процессов, связанных с распознаванием табличной части в документах или в других RPA-задачах, предлагаем Вам заполнить небольшой опросник для получения бесплатной консультации по возможности роботизации по ссылке.